原帖 | Jack | 2024-11-20 15:53 | 👍4 | 阅读约1
往往通用框架为了通用性,往往不会做深度优化(需要传入特定的芯片特性操作),学员在我的建议下,把中断进行优化,效率吞吐率提高了好多倍。
串口定制优化
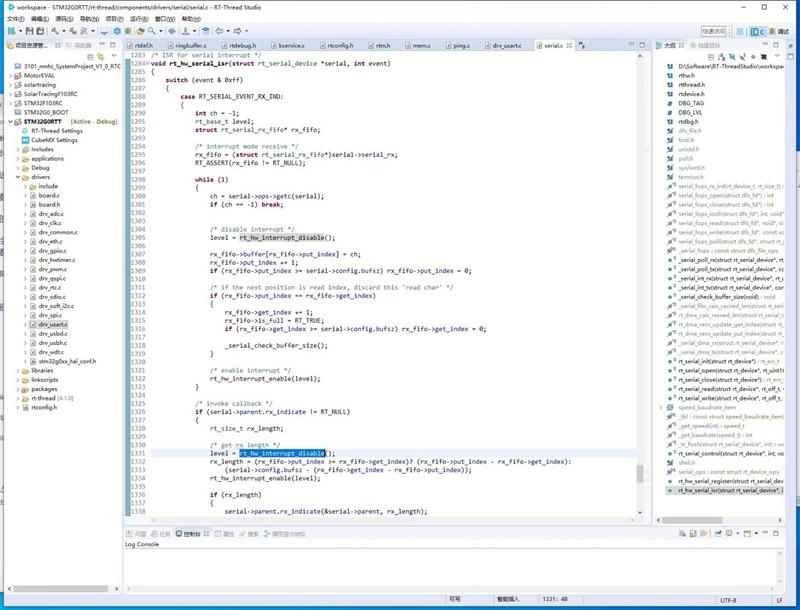
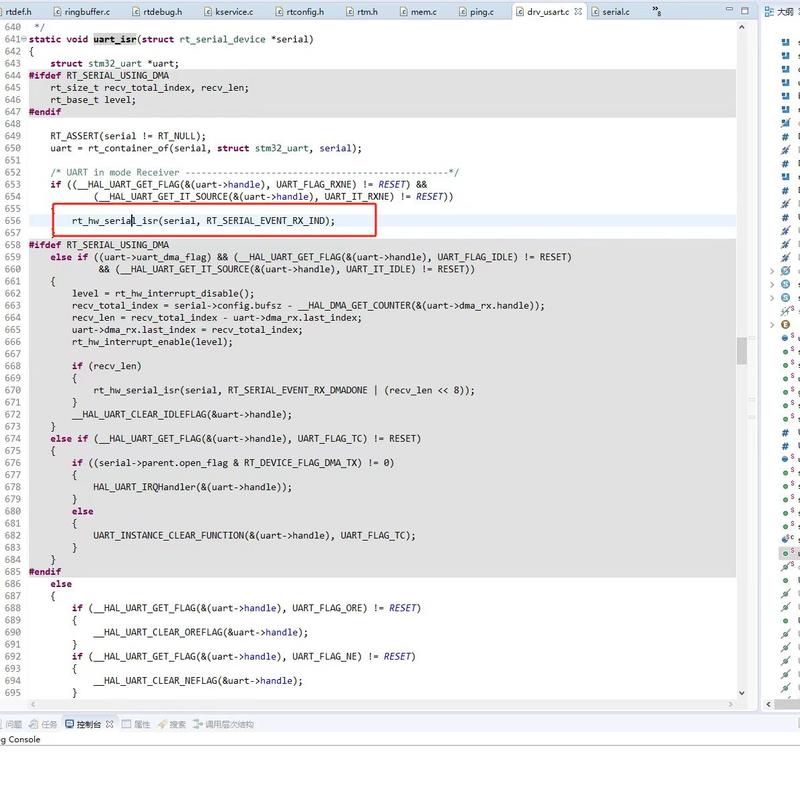
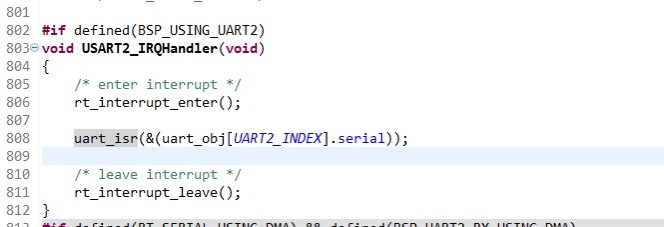
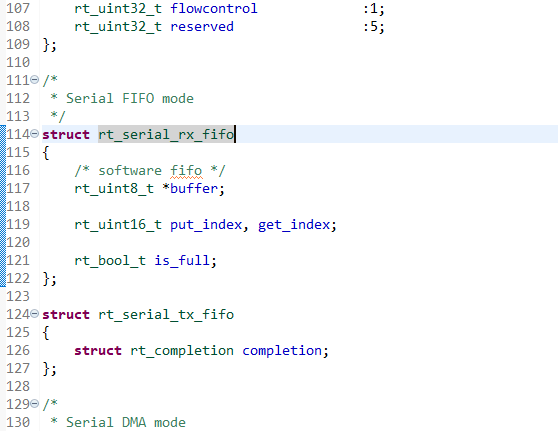
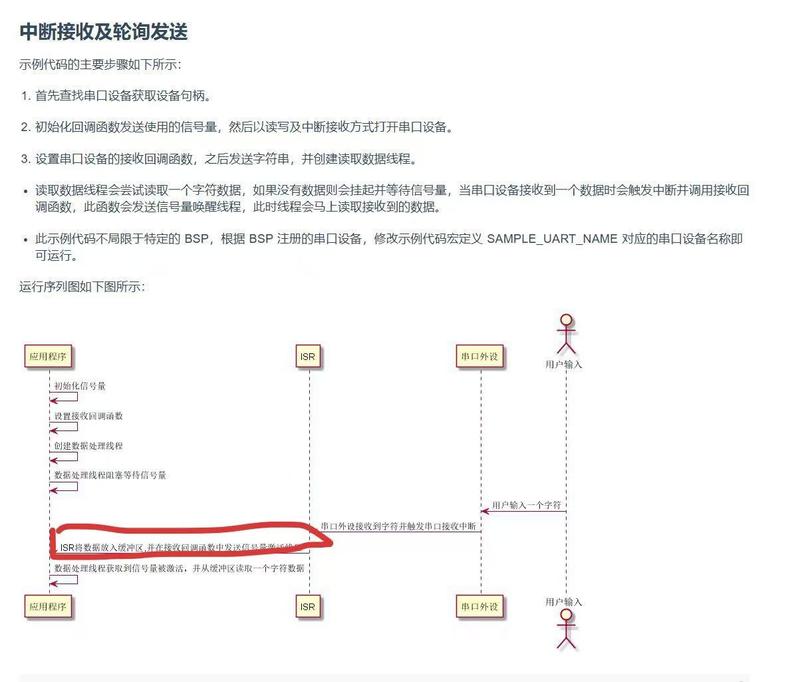
这里就有一次拷贝 这是高速IO的忌讳(队列两次拷贝的背景见 我们在使用队列会存在两次数据拷贝,xQueueSend(...)发一次,)
测试结果:
测试1.拷贝数据的操作依旧保留在中断里,把Buf从1024缩减到512。压力测试环境不变、依然不丢包。中断执行时间缩短到8us。中断进入的间隔2.5ms左右。
测试2.通过任务通知的方式,中断里面计算DMA每次接收的数据大小和数据所在的位置,在线程里面把DMA接收到数组的数据通过memcpy拷贝保存起来,然后用DMA发送。实测不丢包,中断执行时间压缩到2.6us
相关笔记